KI-Vertrauensindex

KI-generierter Code enthält 15 Schwachstellen pro Codebasis,
im Durchschnitt

Durch Tests an 16 führenden KI-Modellen und 1.760 Codebasen haben wir festgestellt, dass das Risiko modell- und frameworkabhängig vorhersehbar ist. Dies liefert Sicherheitsverantwortlichen die Daten, um diese Lücke zu schließen.

Visuellen Bericht herunterladen
Daten erkunden
Getestete KI-Modelle
16
Evaluierte Frameworks
11
Generierte Codebasen
1.760
Eindeutige CWEs gefunden
86
Auf einen Blick

Was ist der SCW AI Trust Index?

Der SCW AI Trust Index ist ein dynamischer Maßstab, der misst, wie häufig führende KI-Modelle Code mit Sicherheitslücken generieren. Er wird bei der Veröffentlichung neuer Modelle aktualisiert – er wird nicht nur einmalig erstellt und dann vernachlässigt.

Visuellen Bericht herunterladen
Dies ist eine dynamische Überschrift mit Tag- und Stiloptionen

Schwachstellen folgen vorhersehbaren Mustern

Schwachstellen folgen vorhersehbaren Mustern. Über 1.760 Codebasen hinweg treten dieselben Schwachstellentypen immer wieder auf – Fehler bei der Protokollierung, Injection-Lücken und fehlerhafte Zugriffskontrollen führen die Liste jedes Mal an. Durch KI generierte Risiken sind wiederholbar, nicht zufällig.

Dies ist eine dynamische Überschrift mit Tag- und Stiloptionen

Jedes Modell hat einen unverwechselbaren Sicherheits-Fingerabdruck

Jedes der 16 Modelle hinterlässt seine eigene, wiederholbare Mischung an OWASP-Kategorien, sodass Teams vorhersehen können – statt nur zu reagieren –, wo ein bestimmtes Modell wahrscheinlich Risiken einführt.

Dies ist eine dynamische Überschrift mit Tag- und Stiloptionen

Kein Modell ist überall führend

Die Sicherheitsführerschaft variiert je nach Framework – GPT-5.1 führt bei der Java Enterprise API, Claude Opus 4.8 bei Python Django. Das richtige Modell hängt davon ab, woran ein Team arbeitet.

Dies ist eine dynamische Überschrift mit Tag- und Stiloptionen

Kosten garantieren keine Sicherheit

Von allen 16 getesteten Modellen belegt das teuerste (Claude Fable 5, 174,94 $ pro Durchlauf) insgesamt den 2. Platz, während das günstigste (Gemini 2.5 Flash, 0,58 $ pro Durchlauf) unter dem Durchschnitt liegt. Der Preis ist also kein Indikator für die Sicherheit.

Schwachstellen

Die häufigste Schwachstelle ist alles andere als exotisch und spiegelt weit verbreitete menschliche Fehler wider

Im gesamten Datensatz wurden 86 eindeutige CWEs identifiziert. Drei davon machen einen unverhältnismäßig großen Anteil aller bestätigten Befunde aus.

Visuellen Bericht herunterladen
CWE-IDNameEchte positive ErgebnisseDurchschnittliches Risiko
CWE-532Einfügen sensibler Informationen in Protokolldateien8.54380,06
CWE-79Unzureichende Neutralisierung von Eingaben bei der Generierung von Webseiten („Cross-Site Scripting“)2.94990,57
CWE-798Verwendung von fest codierten Anmeldedaten1.34868,5
Alle 16 Modelle

Gesamt-Vertrauensindex

Normalisierter Wert, 0–100. Ein höherer Wert bedeutet weniger Schwachstellen im Vergleich zum restlichen Feld – ein Wert von 100 bedeutet die wenigsten Schwachstellen in diesem Datensatz, nicht, dass das Modell frei von Schwachstellen ist.

Visuellen Bericht herunterladen

Die Ergebnisse für die ursprünglichen 6 Modelle unterscheiden sich von der veröffentlichten RMIT-Studie, da der Normalisierungspool von 6 auf 16 Modelle erweitert wurde. Die Werte beziehen sich immer auf die gesamte Kohorte.

Claude Sonnet 5
80,4
Claude Fable 5
76,4
GPT 5.3 Codex
75,3
Claude Opus 4.8
74,5
GPT 5.1
71,6
Gemini 3.1 Pro
66,6
GPT 5.5
66,5
Gemini 2.5 Pro
65,6
Claude Sonnet 4.5
65,2
Gemini 3.5 Flash
59,1
Devstral 2
53,1
Claude Haiku 4.5
50,7
Claude Sonnet 4.6
45,5
Gemini 2.5 Flash
39,4
Qwen3 Coder
32,7
GPT 5 Mini
21,6
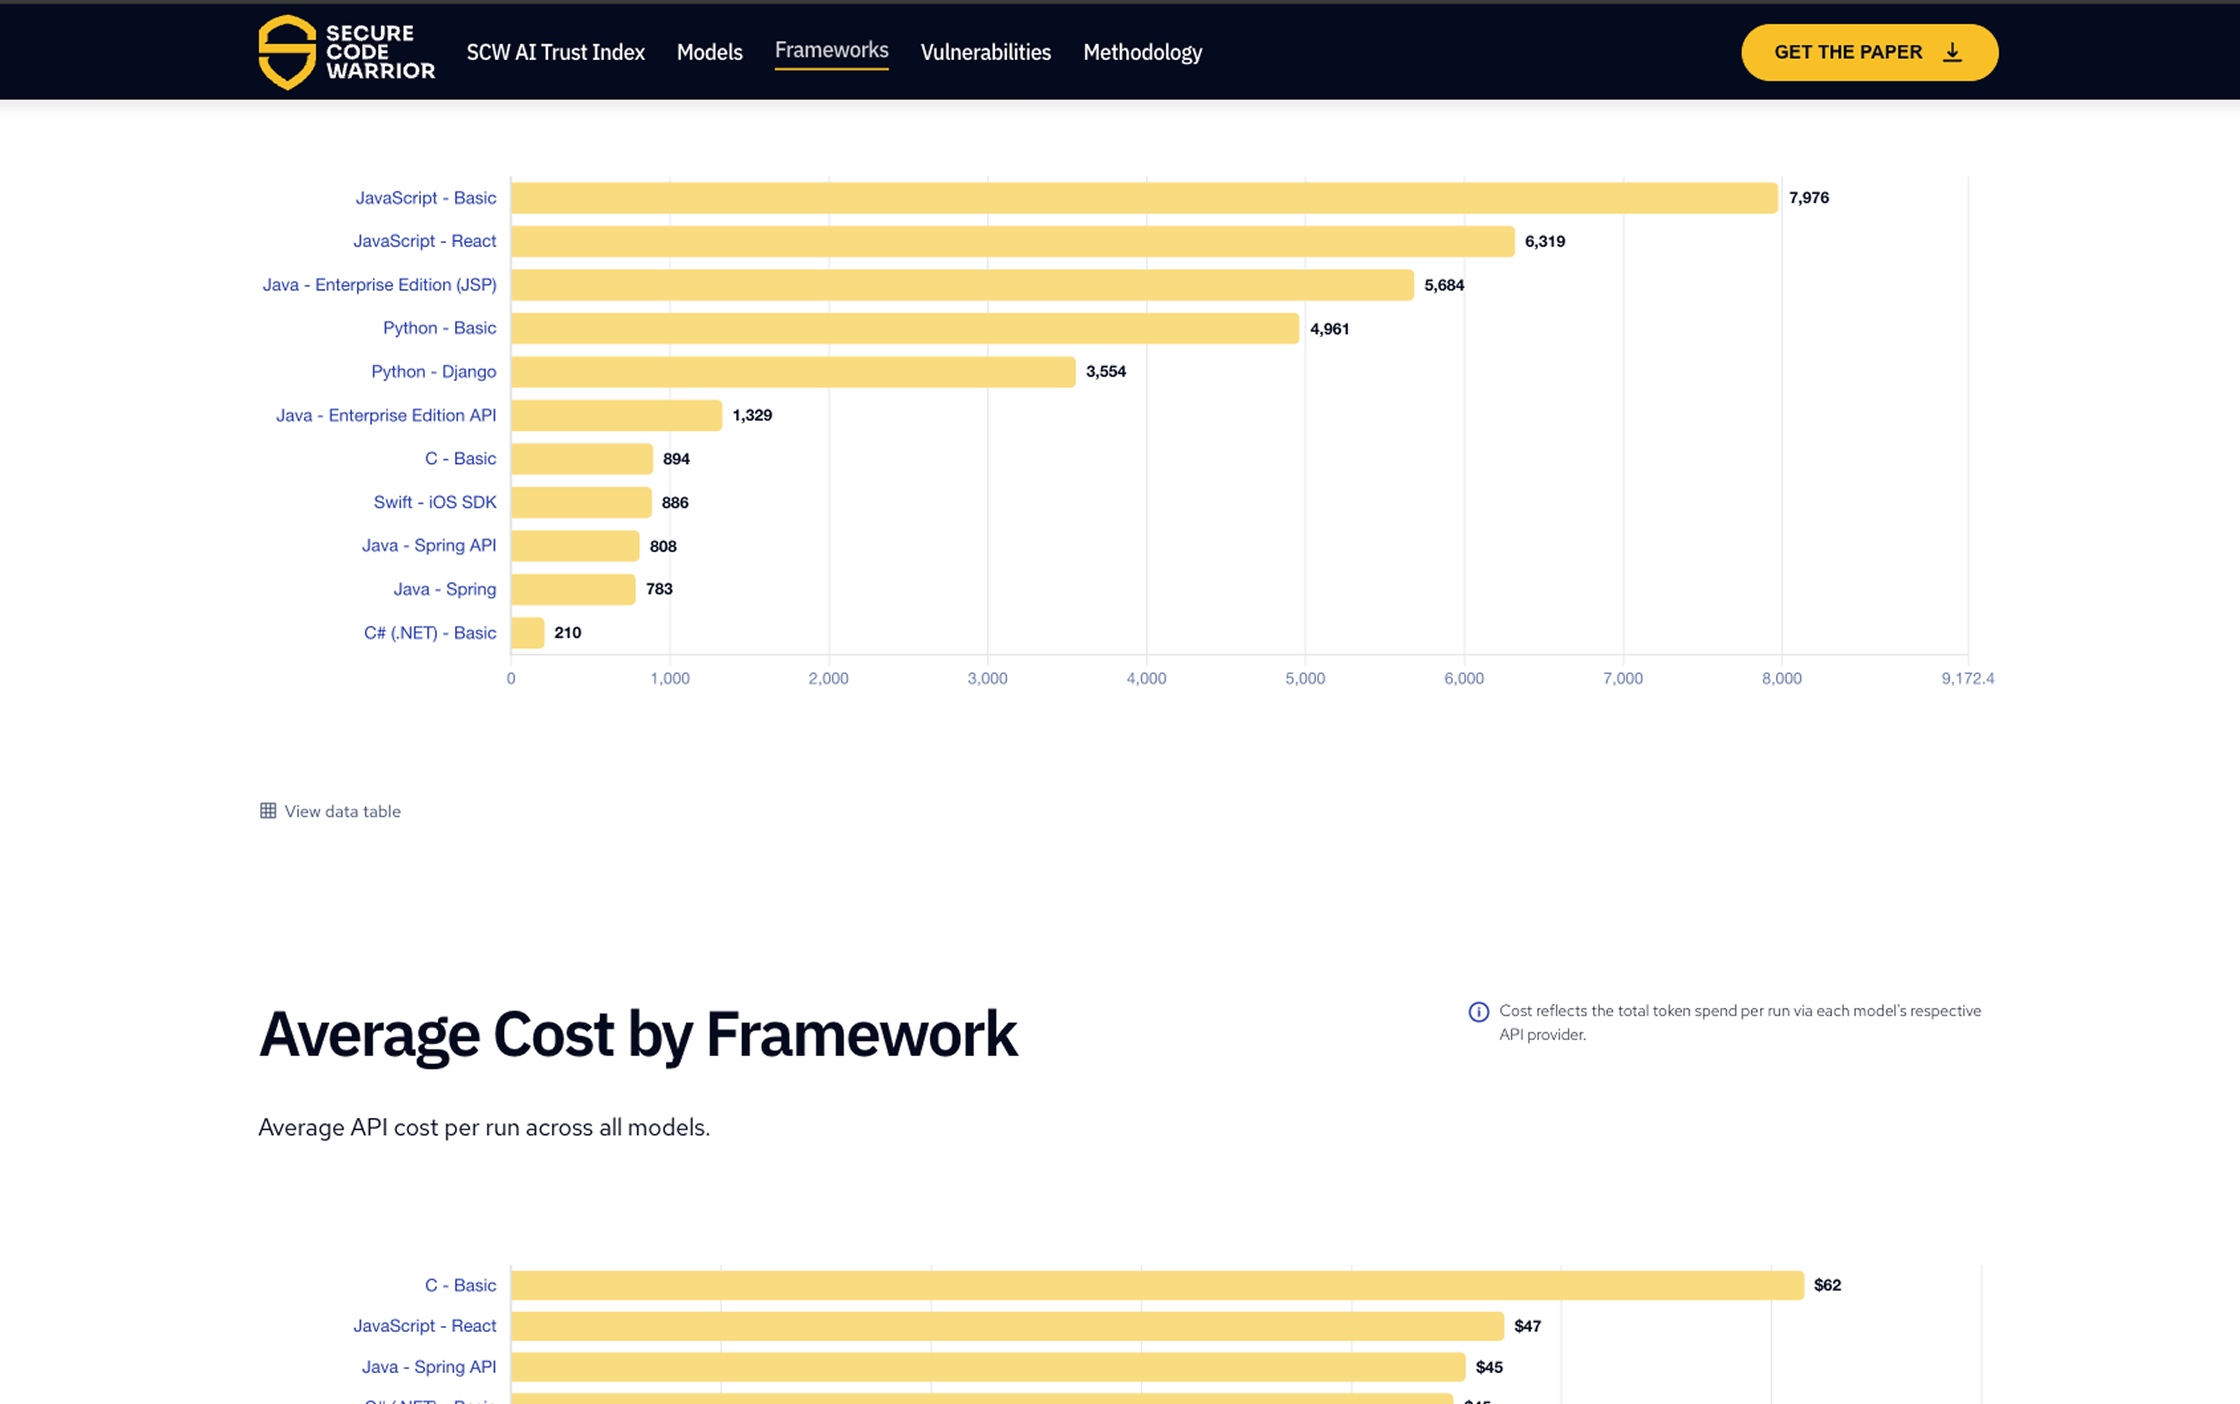
Frameworks

Der Spitzenreiter variiert je nach Framework

Das Gesamtranking eines Modells garantiert nicht, dass es die sicherste Wahl für einen bestimmten Stack ist.

Visuellen Bericht herunterladen
FrameworkFührendes Modell
Java Enterprise APIGPT-5.1
Java SpringClaude Sonnet 4.5
Python DjangoClaude Opus 4.8
C# (.NET)GPT-5.5
CClaude Fable 5
Forschung

So sind wir vorgegangen

Sechzehn KI-Modelle generierten jeweils dieselbe komplexe Spesenverwaltungsanwendung – Authentifizierung, Datei-Upload, Zahlungen, Datenbankzugriff – über 11 Frameworks hinweg, jeweils 10-mal pro Kombination. Jede Codebasis wurde mit denselben Open-Source-Tools für statische Analysen (Semgrep, Bearer, Bandit) gescannt und jedes Ergebnis wurde mithilfe desselben agentenbasierten Prozesses auf False Positives überprüft.

Visuellen Bericht herunterladen
Eindeutige verifizierte Schwachstellenergebnisse
1.554
Bestätigte Schwachstellen (True Positives)
27.000+
Unabhängige SAST-Tools pro Codebasis
3
Durchläufe pro Modell-Framework-Paar
10
Methodik

In Zusammenarbeit mit der RMIT entwickelt

Die ursprüngliche Studie und Methodik wurden in Zusammenarbeit mit der RMIT University entwickelt und deckten die ersten sechs getesteten Modelle ab. Secure Code Warrior hat die Forschung unter Anwendung derselben Methodik eigenständig auf 16 Modelle ausgeweitet.

Vollständige Methodik lesen

Häufig gestellte Fragen

Was ist der SCW AI Trust Index?

Ein dynamischer Benchmark, der misst, wie häufig führende KI-Modelle Code mit Sicherheitslücken generieren. Die Methodik wurde ursprünglich gemeinsam mit der RMIT University entwickelt und von Secure Code Warrior eigenständig auf 16 Modelle ausgeweitet. Er wird bei der Veröffentlichung neuer Modelle laufend aktualisiert und ist keine einmalige Studie.

Wie viele Schwachstellen weist KI-generierter Code im Durchschnitt auf?

Im Durchschnitt 15 bestätigte Schwachstellen pro Codebasis bei den 1.760 getesteten Codebasen, wobei 4 oder mehr in der Regel als kritisch oder hoch eingestuft werden.

Welches KI-Modell erzeugt den sichersten Code?

Kein einzelnes Modell ist in jedem Kontext überlegen. Claude Sonnet 5 erzielte mit 80,4 von 100 Punkten das beste Gesamtergebnis, doch das führende Modell variiert je nach Framework.

Sagt der API-Preis eines Modells etwas über die Sicherheit seines Codes aus?

Nein. Von allen 16 getesteten Modellen belegt das teuerste (Claude Fable 5, 174,94 $ pro Durchlauf) den zweiten Platz, während das günstigste (Gemini 2.5 Flash, 0,58 $ pro Durchlauf) unterdurchschnittlich abschneidet.

Was ist die häufigste Sicherheitslücke in KI-generiertem Code?

CWE-532 – das Schreiben sensibler Informationen wie Passwörter oder Token in Anwendungsprotokolldateien – trat 8.543 Mal auf und damit häufiger als jede andere Schwachstelle im Datensatz.

Wie wurde die Untersuchung durchgeführt?

Sechzehn KI-Modelle erstellten jeweils dieselbe Anwendung in 11 Frameworks, und zwar zehnmal pro Modell. Dabei wurden jedes Mal dieselben Tools und Verifizierungsprozesse eingesetzt.

Haben Sie noch Fragen?

Support-Details, um unentschlossene Kunden zu überzeugen.

Kontakt

Erhalten Sie die Daten, die Ihr Team benötigt, um KI-generierten Code sicher zu verwalten

Laden Sie die visuelle Zusammenfassung für einen schnellen, teilbaren Überblick über die Ergebnisse herunter oder erkunden Sie den vollständigen interaktiven Datensatz – nach Modell, Framework und Schwachstellentyp.

E-BOOK herunterladen
Daten erkunden