Indice de confiance IA

Le code généré par l'IA comporte 15 vulnérabilités par base de code,
en moyenne

Après avoir testé 16 modèles d'IA de premier plan sur 1 760 bases de code, nous avons constaté que le risque est prévisible selon le modèle et le framework, fournissant aux responsables de la sécurité les données nécessaires pour combler les lacunes.

Télécharger le rapport visuel
Explorer les données
Modèles d'IA testés
16
Frameworks évalués
11
Bases de code générées
1 760
CWE uniques identifiées
86
En un coup d'œil

Qu'est-ce que le SCW AI Trust Index ?

Le SCW AI Trust Index est un référentiel dynamique qui mesure la fréquence à laquelle les principaux modèles d'IA génèrent du code comportant des vulnérabilités de sécurité. Il est mis à jour au fur et à mesure de la sortie de nouveaux modèles, plutôt que d'être publié une seule fois et de devenir obsolète.

Télécharger le rapport visuel
Ceci est un titre dynamique avec des options de balise et de style

Les vulnérabilités suivent des schémas prévisibles

Les vulnérabilités suivent des schémas prévisibles. Sur 1 760 bases de code, les mêmes types de faiblesses reviennent systématiquement : échecs de journalisation, failles d'injection et contrôle d'accès défaillant arrivent en tête à chaque fois. Le risque généré par l'IA est reproductible, pas aléatoire.

Ceci est un titre dynamique avec des options de balise et de style

Chaque modèle possède une empreinte de sécurité unique

Chacun des 16 modèles laisse sa propre combinaison reproductible de catégories OWASP, permettant aux équipes d'anticiper — et pas seulement de réagir à — là où un modèle donné est susceptible d'introduire des risques.

Ceci est un titre dynamique avec des options de balise et de style

Aucun modèle ne domine partout

Le leadership en matière de sécurité varie selon le framework : GPT-5.1 est en tête pour l'API Java Enterprise, Claude Opus 4.8 pour Python Django. Le bon modèle dépend de l'environnement de développement de l'équipe.

Ceci est un titre dynamique avec des options de balise et de style

Le coût ne garantit pas la sécurité

Parmi les 16 modèles, le plus coûteux testé (Claude Fable 5, 174,94 $ par exécution) se classe 2e au classement général, tandis que le moins cher (Gemini 2.5 Flash, 0,58 $ par exécution) obtient un score inférieur à la moyenne. Le prix n'est en aucun cas un indicateur de sécurité.

Vulnérabilités

La faille la plus courante est loin d'être exotique et imite une erreur humaine omniprésente

86 CWE uniques ont été identifiées dans l'ensemble des données. Trois d'entre elles représentent une part disproportionnée de toutes les conclusions confirmées.

Télécharger le rapport visuel
ID CWENomVrais positifsRisque moyen
CWE-532Insertion d'informations sensibles dans un fichier journal8 54380,06
CWE-79Neutralisation incorrecte des entrées lors de la génération de pages web (« Cross-site Scripting »)2 94990,57
CWE-798Utilisation d'identifiants codés en dur1 34868,5
Les 16 modèles

Indice de confiance global

Score normalisé, de 0 à 100. Un score plus élevé signifie moins de vulnérabilités par rapport au reste du secteur ; un score de 100 indique le plus faible nombre de vulnérabilités dans cet ensemble de données, et non une absence totale de vulnérabilité.

Télécharger le rapport visuel

Les scores des 6 modèles originaux diffèrent de l'étude RMIT publiée car le groupe de normalisation est passé de 6 à 16 modèles. Les scores sont toujours relatifs à l'ensemble de la cohorte.

Claude Sonnet 5
80,4
Claude Fable 5
76,4
GPT 5.3 Codex
75,3
Claude Opus 4.8
74,5
GPT 5.1
71,6
Gemini 3.1 Pro
66,6
GPT 5.5
66,5
Gemini 2.5 Pro
65,6
Claude Sonnet 4.5
65,2
Gemini 3.5 Flash
59,1
Devstral 2
53,1
Claude Haiku 4.5
50,7
Claude Sonnet 4.6
45,5
Gemini 2.5 Flash
39,4
Qwen3 Coder
32,7
GPT 5 Mini
21,6
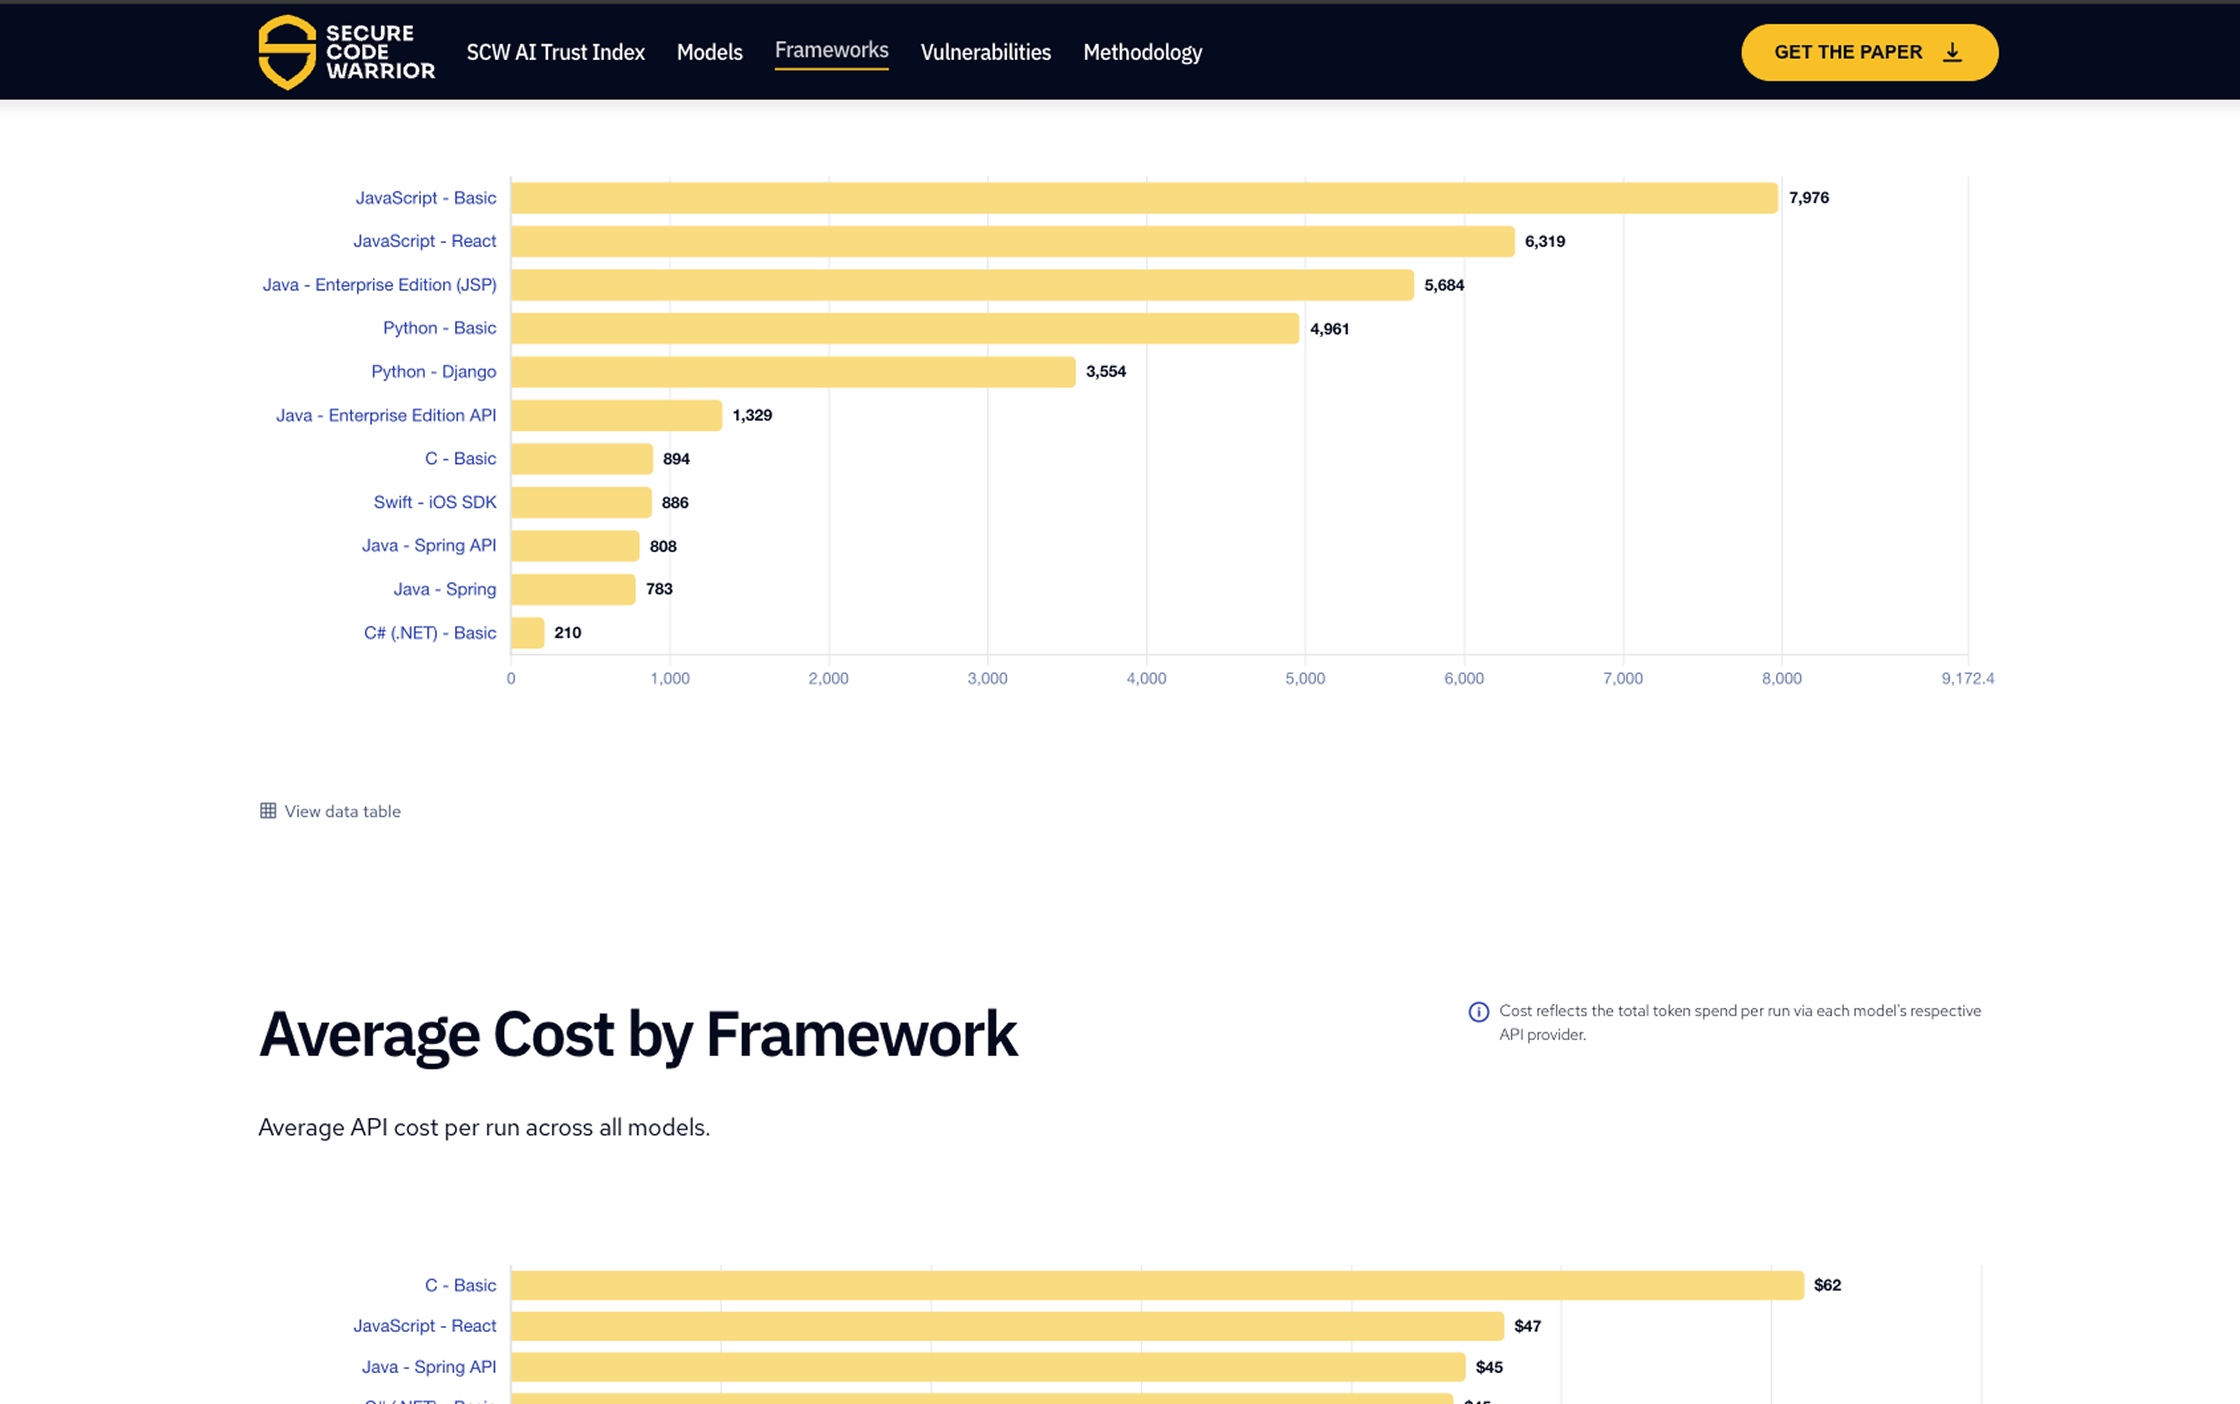
Frameworks

Le leader change selon le framework

Le classement global d'un modèle ne garantit pas qu'il s'agisse du choix le plus sûr pour une pile technologique spécifique.

Télécharger le rapport visuel
FrameworkModèle leader
Java Enterprise APIGPT-5.1
Java SpringClaude Sonnet 4.5
Python DjangoClaude Opus 4.8
C# (.NET)GPT-5.5
CClaude Fable 5
Recherche

Notre démarche

Seize modèles d'IA ont chacun généré la même application complexe de gestion des dépenses — authentification, téléchargement de fichiers, paiements, accès à la base de données — sur 11 frameworks, 10 fois indépendamment par combinaison. Chaque base de code a été analysée avec les mêmes outils d'analyse statique open-source (Semgrep, Bearer, Bandit) et chaque résultat a été vérifié pour éliminer les faux positifs en utilisant le même processus agentique.

Télécharger le rapport visuel
Résultats de vulnérabilités vérifiés et distincts
1 554
Vulnérabilités confirmées (vrais positifs)
27 000+
Outils SAST indépendants par base de code
3
Exécutions par paire modèle/framework
10
Méthodologie

Développé en partenariat avec RMIT

L'étude originale et la méthodologie ont été développées en partenariat avec l'Université RMIT et couvraient les six premiers modèles testés. Secure Code Warrior a étendu indépendamment la recherche à 16 modèles en utilisant cette même méthodologie.

Lire la méthodologie complète

Questions fréquentes

Qu'est-ce que l'indice de confiance SCW AI ?

Un référentiel dynamique qui mesure la fréquence à laquelle les principaux modèles d'IA génèrent du code présentant des vulnérabilités de sécurité. Sa méthodologie, développée initialement avec l'université RMIT, a été étendue de manière indépendante par Secure Code Warrior à 16 modèles. Il est mis à jour au rythme des nouvelles versions plutôt que publié sous forme d'étude ponctuelle.

Combien de vulnérabilités le code généré par l'IA contient-il en moyenne ?

Une moyenne de 15 vulnérabilités confirmées par base de code sur les 1 760 bases testées, dont 4 ou plus sont généralement classées comme critiques ou de haute gravité.

Quel modèle d'IA génère le code le plus sécurisé ?

Aucun modèle ne surpasse les autres dans tous les contextes. Claude Sonnet 5 a obtenu le meilleur score global avec 80,4 sur 100, mais le modèle dominant varie selon le framework.

Le coût de l'API d'un modèle permet-il de prédire la sécurité de son code ?

Non. Parmi les 16 modèles testés, le plus coûteux (Claude Fable 5, 174,94 $ par exécution) se classe 2e au général, tandis que le moins cher (Gemini 2.5 Flash, 0,58 $ par exécution) obtient un score inférieur à la moyenne.

Quelle est la faille de sécurité la plus courante dans le code généré par l'IA ?

La CWE-532 — qui consiste à inscrire des informations sensibles telles que des mots de passe ou des jetons dans les fichiers journaux d'une application — est apparue 8 543 fois, soit plus que toute autre faille dans l'ensemble de données.

Comment la recherche a-t-elle été menée ?

Seize modèles d'IA ont chacun généré la même application sur 11 frameworks, 10 fois chacun, analysés à chaque fois avec les mêmes outils et le même processus de vérification.

Vous avez encore des questions ?

Détails du support pour convaincre les clients hésitants.

Contact

Obtenez les données dont votre équipe a besoin pour gérer le code généré par IA en toute confiance

Téléchargez le résumé visuel pour une vue d'ensemble rapide et partageable des résultats, ou explorez l'ensemble de données interactif complet — par modèle, par framework, par type de vulnérabilité.

Télécharger l'EBOOK
Explorer les données