Índice de confianza en IA

El código generado por IA contiene 15 vulnerabilidades por base de código,
en promedio

Tras analizar 16 modelos de IA líderes y 1760 bases de código, identificamos que el riesgo es predecible según el modelo y el framework, lo que proporciona a los líderes de seguridad los datos necesarios para cerrar la brecha.

Descargar informe visual
Explorar los datos
Modelos de IA probados
16
Frameworks evaluados
11
Bases de código generadas
1760
CWE únicos encontrados
86
De un vistazo

¿Qué es el SCW AI Trust Index?

El SCW AI Trust Index es un punto de referencia dinámico que mide la frecuencia con la que los principales modelos de IA generan código con vulnerabilidades de seguridad. Se actualiza a medida que se lanzan nuevos modelos, en lugar de publicarse una sola vez y quedar obsoleto.

Descargar informe visual
Este es un encabezado dinámico con opciones de etiqueta y estilo

Las vulnerabilidades siguen patrones predecibles

Las vulnerabilidades siguen patrones predecibles. En 1760 bases de código, los mismos tipos de debilidades se repiten: fallos de registro, defectos de inyección y control de acceso deficiente encabezan la lista siempre. El riesgo generado por IA es repetible, no aleatorio.

Este es un encabezado dinámico con opciones de etiqueta y estilo

Cada modelo tiene una huella de seguridad única

Cada uno de los 16 modelos presenta su propia combinación recurrente de categorías OWASP, lo que permite a los equipos anticiparse —y no solo reaccionar— a los riesgos que un modelo determinado podría introducir.

Este es un encabezado dinámico con opciones de etiqueta y estilo

Ningún modelo es superior en todo

El liderazgo en seguridad varía según el framework: GPT-5.1 lidera en Java Enterprise API y Claude Opus 4.8 en Python Django. El modelo adecuado depende de dónde esté desarrollando el equipo.

Este es un encabezado dinámico con opciones de etiqueta y estilo

El costo no garantiza la seguridad

De los 16 modelos analizados, el más costoso (Claude Fable 5, 174,94 $ por ejecución) ocupa el segundo lugar en la clasificación general, mientras que el más económico (Gemini 2.5 Flash, 0,58 $ por ejecución) obtiene una puntuación inferior a la media. El precio no es un indicador de seguridad en ningún sentido.

Vulnerabilidades

El fallo más común no tiene nada de exótico y refleja un error humano generalizado

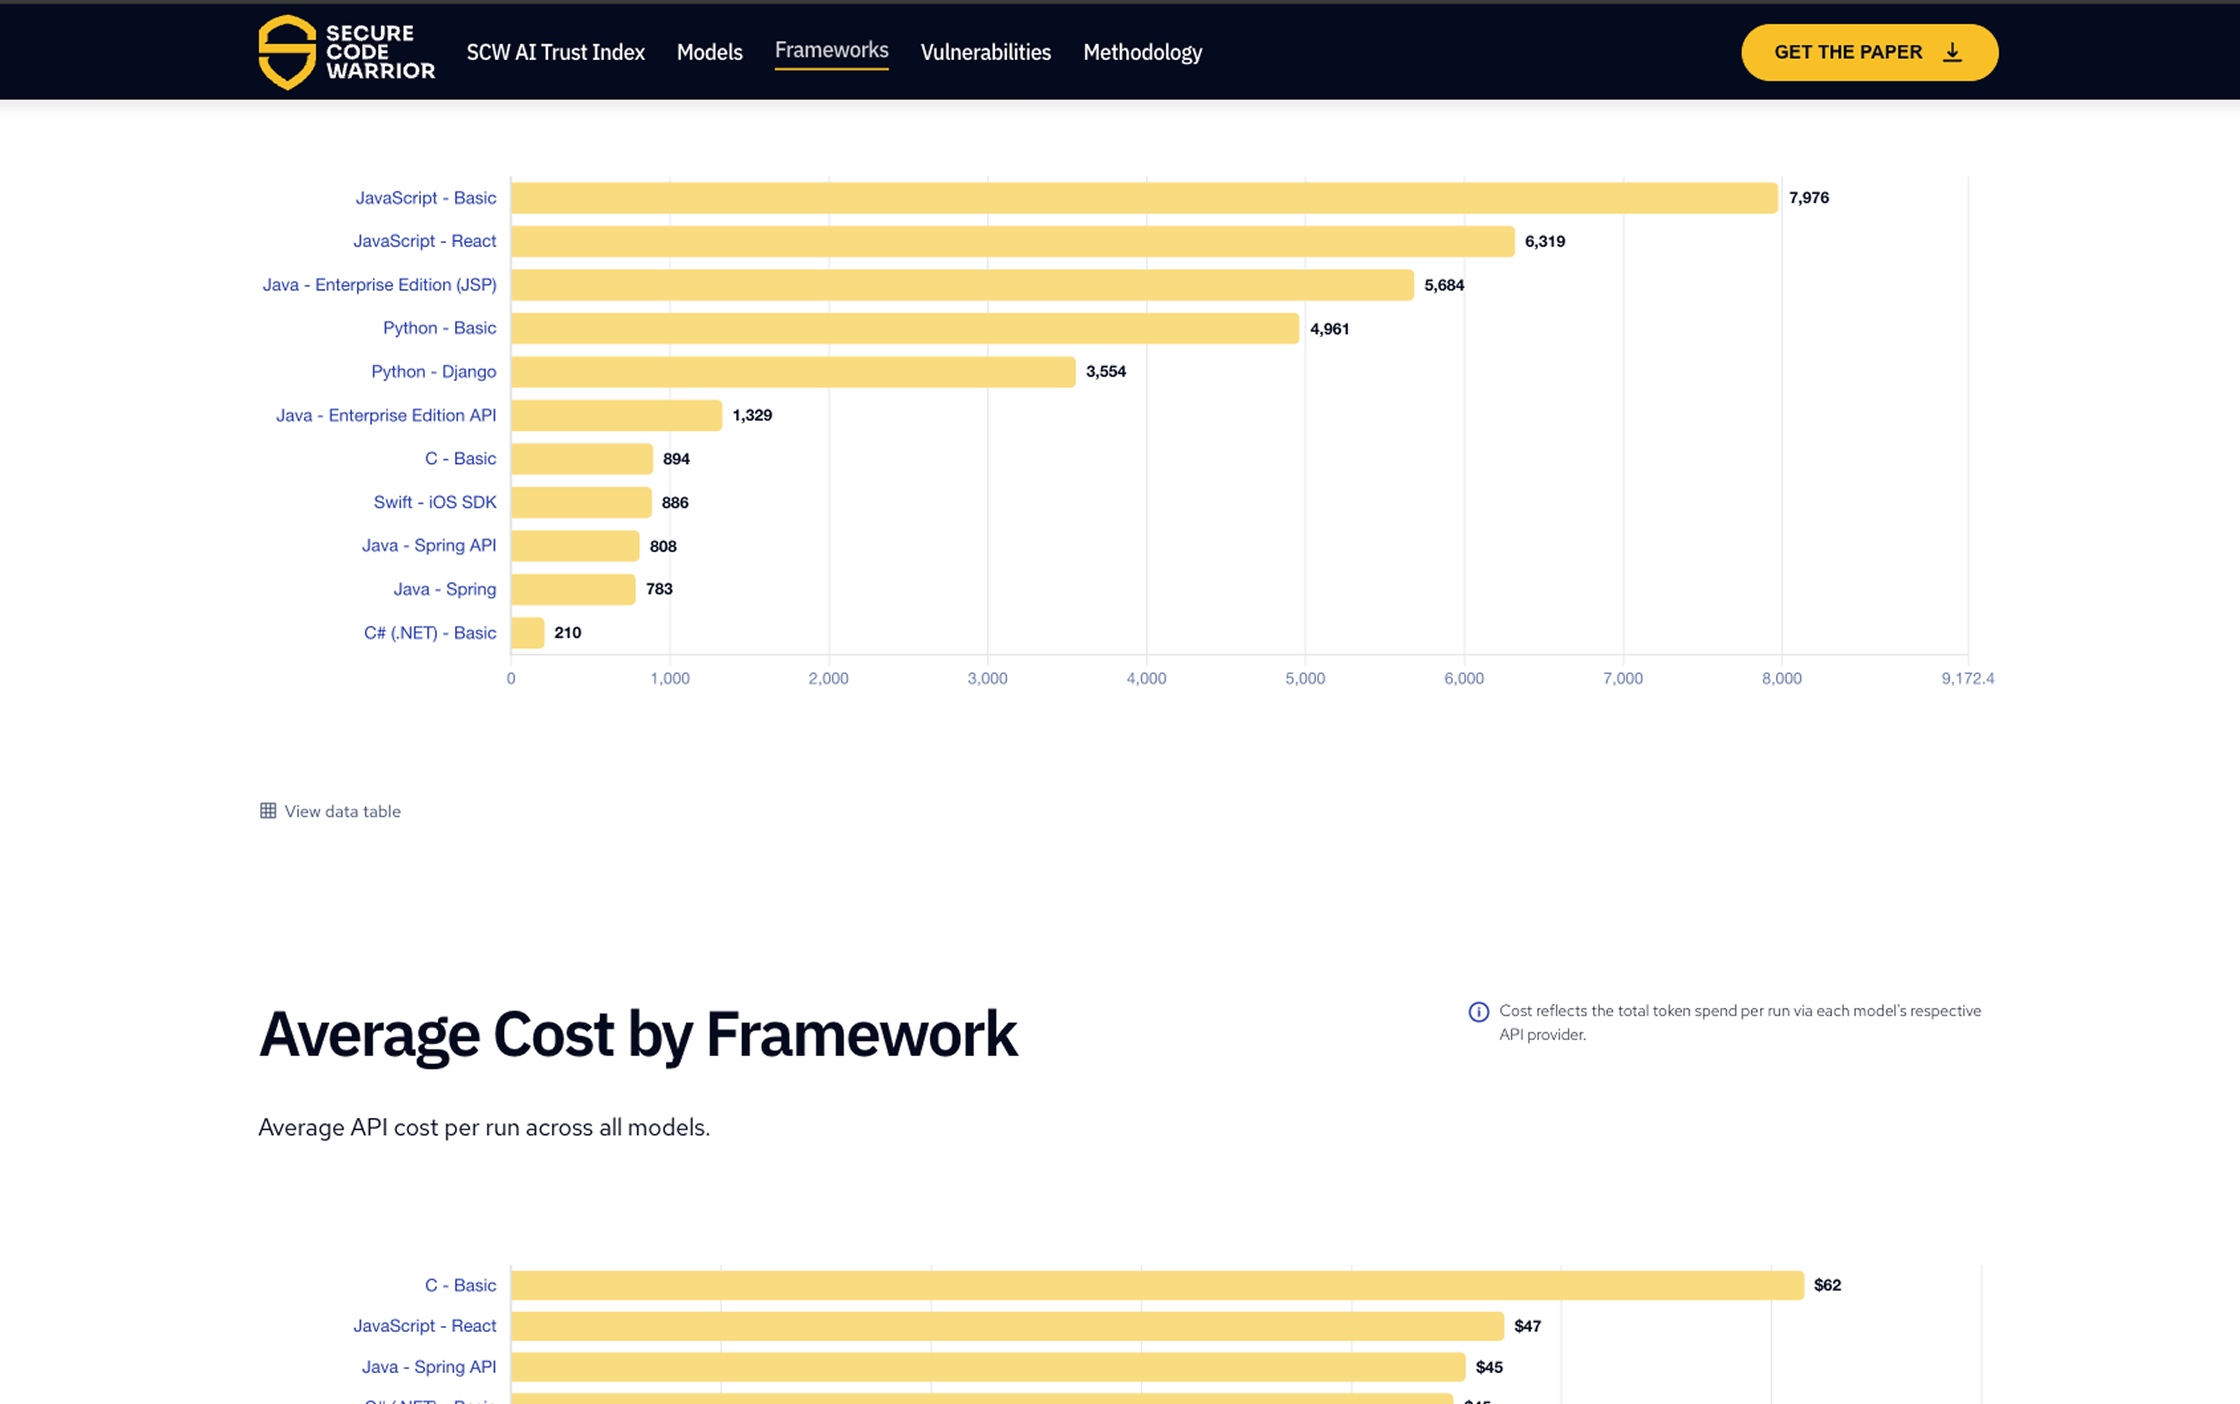
Se identificaron 86 CWE únicos en todo el conjunto de datos. Tres de ellos representan una parte desproporcionada de todos los hallazgos confirmados.

Descargar informe visual
ID de CWENombreVerdaderos positivosRiesgo promedio
CWE-532Inserción de información confidencial en archivos de registro8.54380,06
CWE-79Neutralización inadecuada de entradas durante la generación de páginas web ('Cross-site Scripting')2.94990,57
CWE-798Uso de credenciales codificadas de forma rígida1.34868,5
Los 16 modelos

Índice de confianza general

Puntuación normalizada, 0–100. Una cifra más alta significa menos vulnerabilidades en relación con el resto del sector; una puntuación de 100 indica la menor cantidad en este conjunto de datos, no que esté libre de vulnerabilidades.

Descargar informe visual

Las puntuaciones de los 6 modelos originales difieren del estudio publicado por RMIT porque el grupo de normalización se amplió de 6 a 16 modelos. Las puntuaciones siempre son relativas a la cohorte completa.

Claude Sonnet 5
80.4
Claude Fable 5
76.4
GPT 5.3 Codex
75.3
Claude Opus 4.8
74.5
GPT 5.1
71.6
Gemini 3.1 Pro
66.6
GPT 5.5
66,5
Gemini 2.5 Pro
65,6
Claude Sonnet 4.5
65,2
Gemini 3.5 Flash
59,1
Devstral 2
53,1
Claude Haiku 4.5
50,7
Claude Sonnet 4.6
45,5
Gemini 2.5 Flash
39,4
Qwen3 Coder
32,7
GPT 5 Mini
21,6
Frameworks

El líder cambia según el framework

La clasificación general de un modelo no garantiza que sea la opción más segura para un stack específico.

Descargar informe visual
FrameworkModelo líder
Java Enterprise APIGPT-5.1
Java SpringClaude Sonnet 4.5
Python DjangoClaude Opus 4.8
C# (.NET)GPT-5.5
CClaude Fable 5
Investigación

Cómo lo hicimos

Dieciséis modelos de IA generaron la misma aplicación compleja de gestión de gastos (autenticación, carga de archivos, pagos, acceso a bases de datos) en 11 marcos de trabajo, 10 veces de forma independiente por combinación. Cada base de código se analizó con las mismas herramientas de análisis estático de código abierto (Semgrep, Bearer, Bandit) y cada hallazgo se verificó para descartar falsos positivos utilizando el mismo proceso agente.

Descargar informe visual
Hallazgos de vulnerabilidades verificados y distintos
1.554
Vulnerabilidades confirmadas (positivos reales)
27.000+
Herramientas SAST independientes por base de código
3
Ejecuciones por par de modelo/marco de trabajo
10
Metodología

Desarrollado en colaboración con RMIT

El estudio y la metodología originales se desarrollaron en colaboración con la Universidad RMIT y cubrieron los primeros seis modelos probados. Secure Code Warrior amplió la investigación de forma independiente a 16 modelos utilizando esa misma metodología.

Leer la metodología completa

Preguntas frecuentes

¿Qué es el Índice de Confianza en IA de SCW?

Un punto de referencia dinámico que mide la frecuencia con la que los principales modelos de IA generan código con vulnerabilidades de seguridad. Su metodología fue desarrollada originalmente junto con la RMIT University y, desde entonces, Secure Code Warrior la ha ampliado de forma independiente a 16 modelos. Se actualiza a medida que aparecen nuevos modelos, en lugar de publicarse como un estudio único.

¿Cuántas vulnerabilidades tiene, en promedio, el código generado por IA?

Un promedio de 15 vulnerabilidades confirmadas por base de código en las 1760 bases de código analizadas, de las cuales 4 o más suelen clasificarse como de gravedad crítica o alta.

¿Qué modelo de IA genera el código más seguro?

Ningún modelo destaca en todos los contextos. Claude Sonnet 5 obtuvo la puntuación global más alta con 80,4 sobre 100, pero el modelo líder varía según el framework.

¿El costo de la API de un modelo predice qué tan seguro es su código?

No. De los 16 modelos analizados, el más caro (Claude Fable 5, 174,94 $ por ejecución) ocupa el segundo lugar, mientras que el más barato (Gemini 2.5 Flash, 0,58 $ por ejecución) obtiene una puntuación inferior a la media.

¿Cuál es la vulnerabilidad de seguridad más común en el código generado por IA?

CWE-532 —escribir información confidencial, como contraseñas o tokens, en los archivos de registro de la aplicación— apareció 8.543 veces, más que cualquier otra vulnerabilidad en el conjunto de datos.

¿Cómo se llevó a cabo la investigación?

Dieciséis modelos de IA generaron la misma aplicación en 11 marcos de trabajo, 10 veces cada uno, analizados con las mismas herramientas y el mismo proceso de verificación en cada ocasión.

¿Todavía tiene preguntas?

Detalles de soporte para captar a los clientes que aún no se han decidido.

Contacto

Obtenga los datos que su equipo necesita para gestionar el código generado por IA con confianza

Descargue el resumen visual para obtener una visión general rápida y compartible de los hallazgos, o explore el conjunto de datos interactivo completo: por modelo, por marco de trabajo y por tipo de vulnerabilidad.

Descargar el EBOOK
Explorar los datos