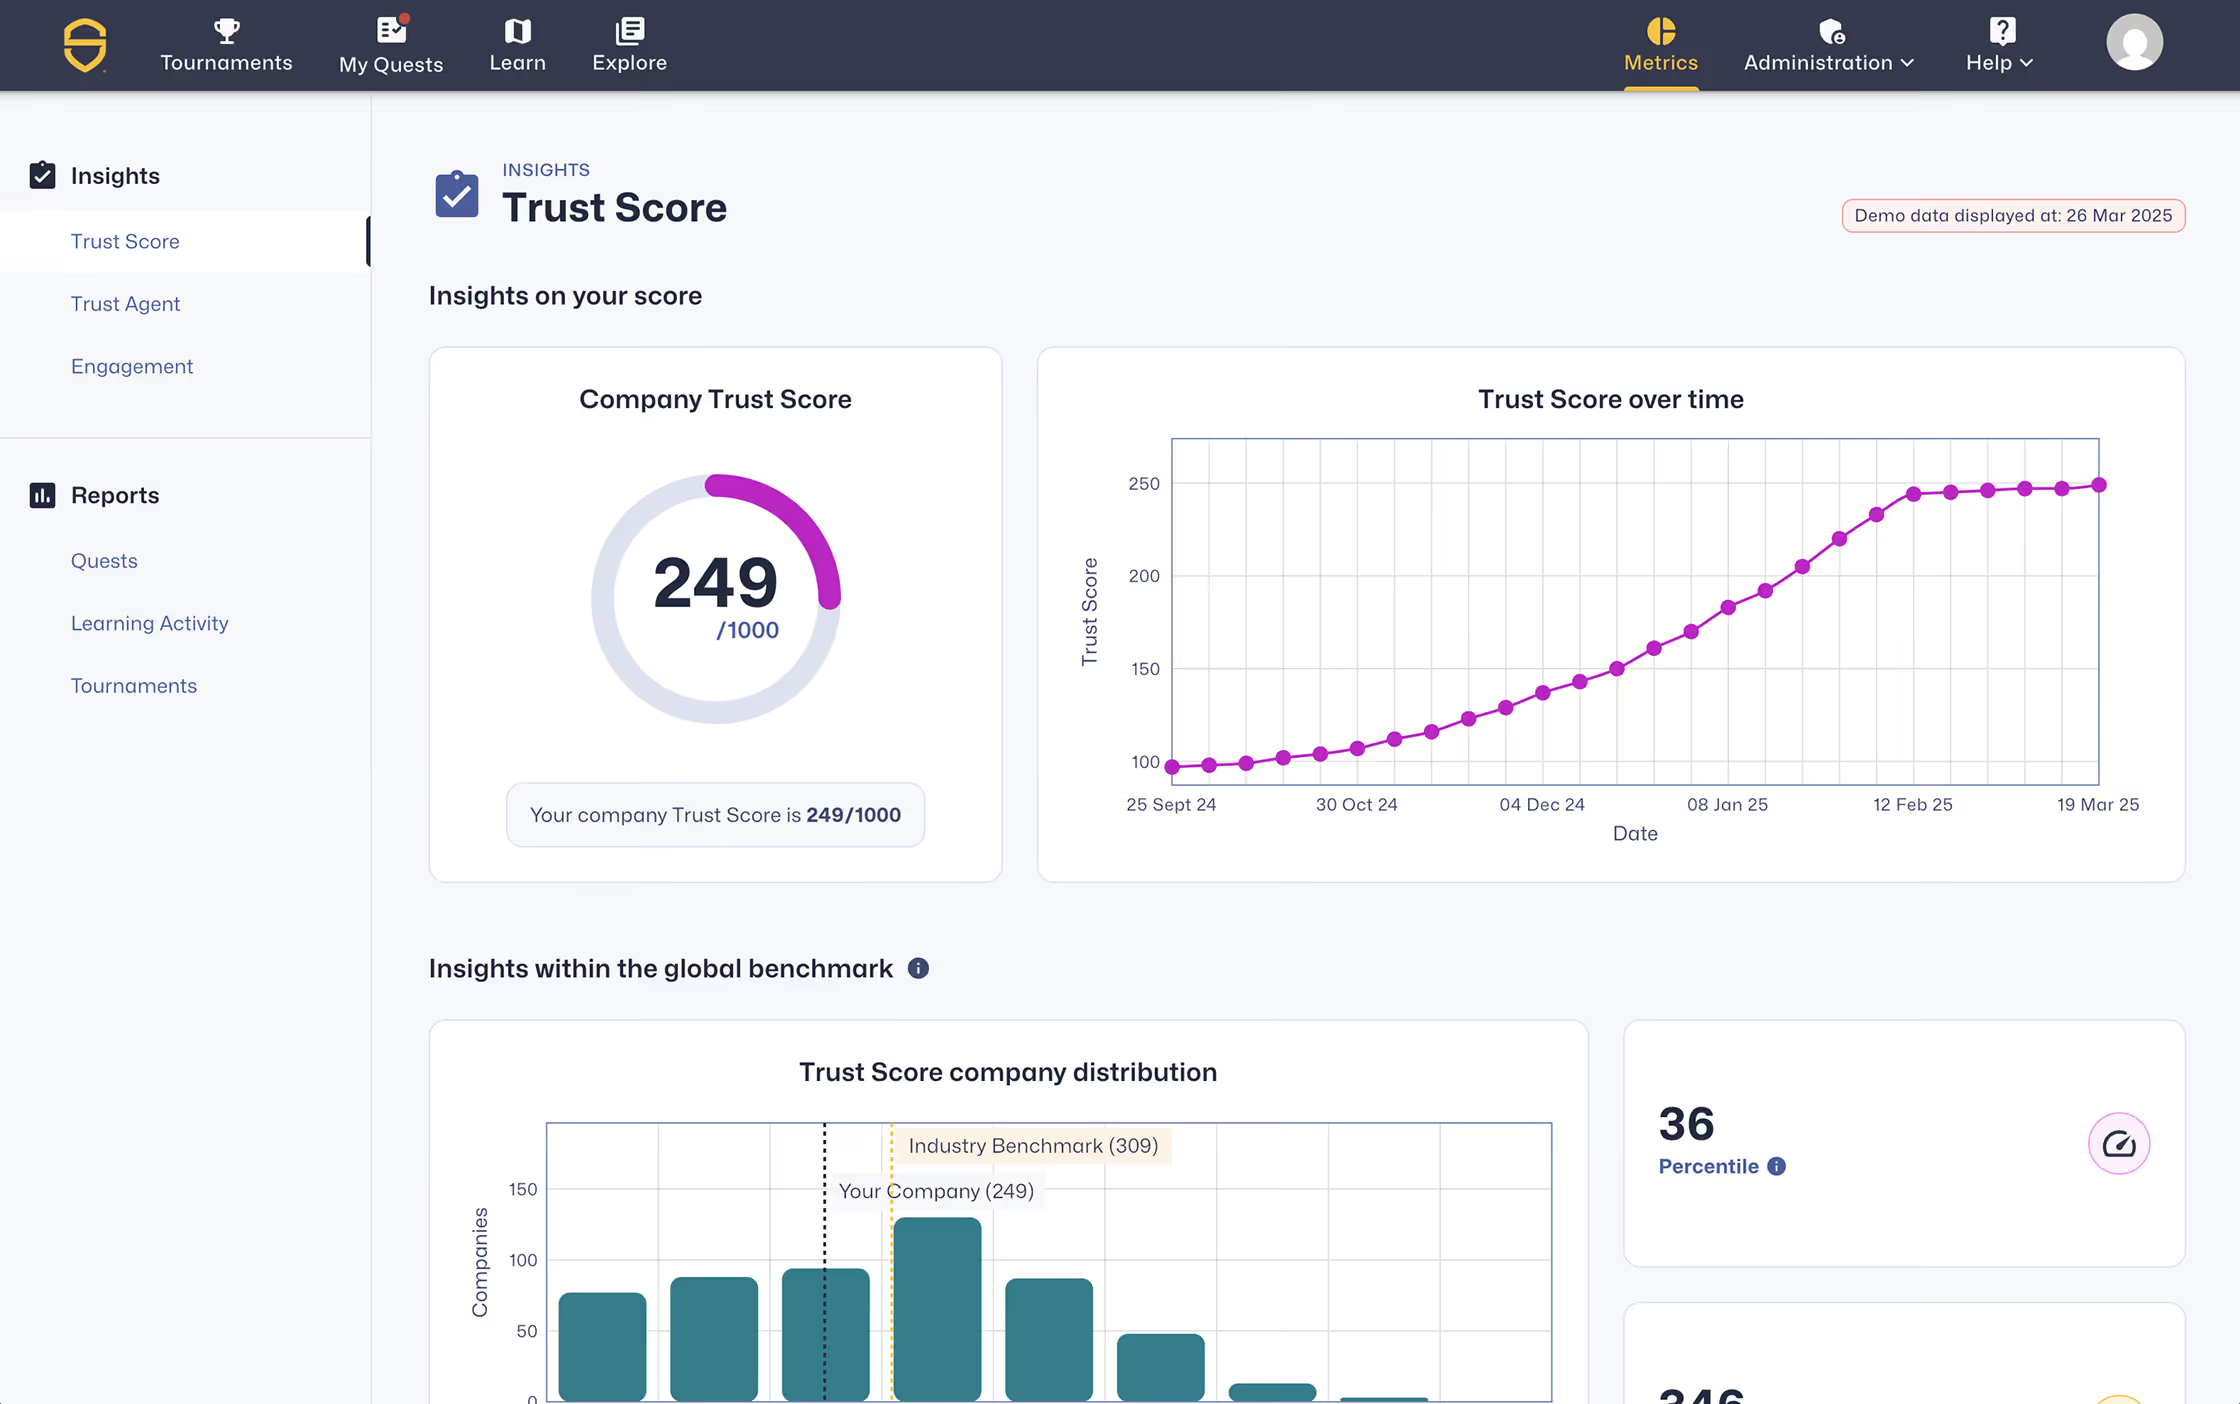
Vous êtes CISO ou responsable technique et la sécurité ainsi que le coût de la génération de code par LLM vous préoccupent ?

Consultez le SCW AI Trust Index, nos données propriétaires d'analyse comparative des LLM, avant de vous lancer tête baissée dans un modèle d'IA
Le secteur de la cybersécurité est en état de saturation. Des outils comme Mythos d'Anthropic (et Fable 5, rapidement retiré puis relancé) poussent de nombreux responsables de la sécurité à renforcer rapidement leurs programmes pour suivre l'évolution fulgurante de la vitesse d'exploitation, sans parler du volume de code bien plus élevé généré par l'IA.
Dans ce contexte, il peut être tentant de se précipiter sur des mesures de sécurité préventives (et, soyons honnêtes, réactives) pour contrer une vague perçue de risques de violation liés à l'IA. Cependant, un problème bien plus omniprésent affecte aujourd'hui probablement tous les RSSI : le choix des modèles de LLM dans les environnements de production logicielle. Si les conséquences de l'IA fantôme sont bien documentées, ce n'est qu'une partie du problème. Nous ne devrions pas payer des jetons pour générer du code, payer davantage pour utiliser l'IA afin de détecter des failles de sécurité, puis payer encore pour générer et appliquer des correctifs. Chaque modèle d'IA est susceptible de produire des faiblesses et des vulnérabilités à des taux variables, surtout lorsque l'on compare les performances entre différents frameworks ou langages de programmation. À cet égard, il est nécessaire de déterminer le modèle le plus adapté pour soutenir la pile technologique, les langages et les frameworks utilisés, une information jusqu'ici difficile à obtenir.
Secure Code Warrior s'est associé à des chercheurs clés de l'Université RMIT, et nous avons passé des mois à poser une question faussement simple : lorsque vous confiez votre base de code à un modèle d'IA, quel niveau de risque de sécurité héritez-vous exactement ? La réponse, basée sur notre étude empirique de plus de 1 700 bases de code complètes générées par des modèles de pointe et des modèles économiques, sur onze frameworks de langage, est : bien plus que vous ne le pensez, et de manières qui vous surprendront.
Voici les cinq points essentiels à retenir de notre rapport de recherche pour intégrer votre programme de sécurité dans l'ère de l'IA :
1. Le coût n'est pas un indicateur de sécurité.
Il est tentant de supposer que payer plus cher garantit un code généré plus sûr. Nos données montrent que la réalité est plus nuancée. GPT 5.1 a obtenu le score de sécurité normalisé global le plus élevé de notre étude initiale — 79,6 sur 100 — pour un coût moyen de 5,60 $ par exécution. Claude Sonnet 4.5 a obtenu 71,2, un score nettement inférieur, pour 43,99 $ par exécution. Cela représente un coût près de 8 fois supérieur pour un résultat de sécurité moindre.
L'écart de coût ne s'explique pas uniquement par la tarification au jeton. Les modèles d'Anthropic ont effectué beaucoup plus d'appels d'outils au sein de la boucle de codage agentique, générant 176 millions de jetons de sortie lors des exécutions de Sonnet 4.5, contre 42 millions pour GPT 5.1, par exemple. Plus d'activité, plus de jetons et plus de coûts n'ont pas apporté plus de sécurité. Le budget n'est pas synonyme de qualité, alors ne le laissez pas remplacer une évaluation rigoureuse.
2. Chaque modèle possède une empreinte de vulnérabilité.
Sur plus de 1 700 bases de code et 16 modèles, nous avons identifié 83 catégories uniques de CWE avec des résultats validés comme vrais positifs. Ces erreurs ne sont pas aléatoires ; chaque modèle présente un schéma systématique qui persiste indépendamment du framework ou du langage. Dans notre étude initiale sur 6 modèles, 39 des 87 catégories de CWE identifiées étaient produites par chaque modèle testé, ce qui montre qu'un noyau important de types de vulnérabilités est agnostique au modèle, et non spécifique au fournisseur. Les modèles Claude d'Anthropic, par exemple, ont montré une tendance récurrente aux identifiants codés en dur (CWE-798). Gemini 2.5 Flash a systématiquement laissé du code de débogage dans les builds de production (CWE-489).
Ces empreintes suggèrent des biais liés aux données d'entraînement ou à l'alignement plutôt qu'un bruit aléatoire. Cette prévisibilité est en réalité utile : une fois que vous connaissez les angles morts de votre modèle, vous pouvez configurer des règles d'analyse ciblées et des contrôles post-génération adaptés.
3. Certaines vulnérabilités sont universelles… et aucun modèle testé ne les évite.
Par exemple, l'une des découvertes les plus omniprésentes dans notre index actuel est la CWE-532 (Insertion d'informations sensibles dans un fichier journal), apparue 6 765 fois en tant que vrai positif.
Chaque modèle a travaillé à partir de la même spécification d'application ordinaire, le genre de brief en langage clair qu'une équipe produit rédige chaque jour, et non une liste de contrôle de sécurité ou un prompt simplifié conçu pour provoquer l'échec. Plutôt que d'indiquer un cas limite exotique, la plupart des autres vulnérabilités révèlent des défauts d'omission : identifiants laissés dans le code source, paramètres par défaut trop permissifs, absence de contrôles d'autorisation ; le genre de lacune qui disparaît dès que vous la demandez explicitement, car le modèle ne l'inférera pas de lui-même à partir d'une spécification ordinaire. L'exception est la découverte majeure elle-même : la journalisation de données sensibles n'est pas quelque chose que les modèles ont oublié d'ajouter, c'est quelque chose qu'ils ont activement écrit, sans y être invités, de la même manière qu'un développeur humain peu qualifié pourrait le faire. Cela est entièrement volontaire de la part du modèle, sans qu'un humain n'ait explicitement demandé ce comportement. Le modèle implémente fidèlement ce qui est décrit dans le prompt, y compris tout ce qui n'est pas mentionné sous l'angle du renforcement de la sécurité.
4. Le contexte du framework façonne les performances du modèle.
Cette découverte devrait remodeler la façon dont les organisations envisagent le développement assisté par l'IA. L'étude montre clairement que les forces des modèles varient selon les piles technologiques. Un modèle performant dans un framework peut être moins efficace dans un autre ; les équipes doivent donc évaluer les modèles là où ils seront réellement utilisés.
Dans notre SCW AI Trust Index actuel, l'écart entre les frameworks dépasse celui entre les modèles. JavaScript Basic — agrégé sur l'ensemble des 13 modèles testés — affiche un score de risque total de 6 770. C#/.NET Basic, le framework le plus sûr de l'étude, se situe à seulement 111. Il s'agit d'une différence de risque de sécurité de 61 fois, due uniquement au choix du framework.
Notre étude initiale a révélé la raison probable : les frameworks avec des paramètres de sécurité par défaut stricts, par exemple C# avec les jetons anti-contrefaçon intégrés d'ASP.NET ou le modèle de sécurité déclaratif de Java Spring, ont produit un code nettement plus sûr, quel que soit le modèle utilisé. Les environnements bruts comme JavaScript Basic amplifient les différences entre les modèles de manière catastrophique. Choisissez votre framework en donnant la priorité à la sécurité, si possible, au sein de votre organisation.
5. Aucun modèle n'est performant partout ; le choix du modèle doit tenir compte du framework utilisé.
Dans notre étude initiale, GPT 5.1 arrivait en tête globalement, mais dernier pour Swift iOS. Sonnet 4.5 a généré le code Java Spring le plus sûr de toute l'étude, avant de se classer dernier pour l'API Java EE. Gemini 2.5 Pro a dominé Python et Swift, tout en restant moyen en Java. Il n'existe pas de modèle universellement sûr.
Les organisations dotées de bases de code polyglottes doivent soit accepter des angles morts spécifiques aux modèles dans leur pile technique, soit adopter une stratégie de routage associant chaque framework au modèle présentant le meilleur profil de sécurité pour ce contexte. Quel que soit le modèle choisi, l'analyse de sécurité est indispensable. Même le modèle le plus performant a généré des vulnérabilités validées dans chacun des frameworks testés.
Cette pression sur les coûts ne va pas disparaître. À mesure que les flux de travail des agents se développent, la facture augmente : plus d'appels d'outils, plus de cycles de régénération, plus de jetons par tâche. Il est fort probable que la hausse des coûts par tâche et par jeton pousse certaines organisations vers des modèles plus anciens ou moins chers pour maîtriser leurs dépenses. Nos données montrent que cette décision doit reposer sur des preuves, et non sur l'intuition : GPT 5 Mini était à la fois le modèle le moins cher de notre étude initiale et le moins sécurisé. La pression financière est réelle, et elle doit vous inciter à mesurer plutôt qu'à deviner.
La question n'a jamais été de savoir s'il fallait analyser ou non ; les responsables de la sécurité doivent avant tout collecter les données, les signaux de risque et l'observabilité de l'IA pertinents pour savoir quoi analyser. C'est là que la gouvernance de l'IA joue un rôle majeur, et nous proposons une solution complète pour fournir ces informations essentielles dès maintenant.
>>> EN SAVOIR PLUS: SCW Trust Agent : IA
>>> TÉLÉCHARGER: eBook
>>> DÉCOUVRIR: Notre microsite de benchmarking (le rapport de recherche complet sera lié ici)
Gouvernez le développement assisté par IA avant la mise en production
Évaluez les risques liés à l'IA, appliquez des politiques de codage sécurisé dès le commit et accélérez la livraison sécurisée tout au long de votre cycle de développement.
Explorer plus d'articles
Accédez à du contenu expert sur le codage sécurisé, la gouvernance de l'IA et la gestion des risques logiciels.

Supercharged Security Awareness: How Tournaments are Inspiring Developers at Erste Group
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Suspendisse varius enim in eros elementum tristique. Duis cursus, mi quis viverra ornare, eros dolor interdum nulla, ut commodo diam libero vitae erat. Aenean faucibus nibh et justo cursus id rutrum lorem imperdiet. Nunc ut sem vitae risus tristique posuere.
Security as culture: How Blue Prism cultivates world-class secure developers
Learn how Blue Prism, the global leader in intelligent automation for the enterprise, used Secure Code Warrior's agile learning platform to create a security-first culture with their developers, achieve their business goals, and ship secure code at speed

Une culture de la sécurité : comment Sage a bâti son programme de champions
Découvrez comment Sage a renforcé sa sécurité grâce à une approche flexible axée sur les relations humaines, formant plus de 200 champions de la sécurité et obtenant une réduction mesurable des risques.

Mois de la sensibilisation à la cybersécurité 2026 : comprendre la sécurité de l'IA est essentiel à la défense de l'entreprise
Nous avons atteint un point où la plupart des grandes entreprises d'IA ont publiquement appelé à un ralentissement mondial du développement de l'IA afin de permettre aux garde-fous de sécurité de rattraper leur retard. Pourtant, la réalité est que de graves problèmes de sécurité se sont déjà concrétisés. Cela place d'innombrables responsables de la sécurité et équipes de direction dans une situation d'urgence, alors que les coûts financiers et les risques liés à la mise en œuvre de l'IA ne cessent de s'accumuler.
Levier 8 : Valoriser votre programme
Un programme de codage sécurisé a besoin de plus qu'un contenu de qualité pour réussir. Le levier 8 montre comment l'image de marque transforme la participation en une expérience convoitée, axée sur le statut.
Chaque employé est désormais en première ligne de la cybersécurité IA
Le paysage technologique des entreprises évolue à une vitesse que peu avaient anticipée avant qu'il ne soit trop tard. Nous avons officiellement franchi le cap du code écrit par l'humain et de l'assistance basique par copilote pour entrer dans l'ère du cycle de vie de développement agentique (ADLC). Si les agents IA autonomes promettent une efficacité sans précédent dans de multiples fonctions, ils apportent également une toute nouvelle catégorie de risques en matière de sécurité et de réglementation.
Sécurisez le développement piloté par l'IA avant le déploiement
Identifiez les risques de développement, appliquez vos politiques et prévenez les vulnérabilités tout au long du cycle de vie de vos logiciels.